Chaves espalhadas
Cada time contratou seu provedor. Não existe a lista de quantas chaves a empresa tem, quem as guarda, nem o que passa por elas.
Plataforma de agentes de IA
Cada time com sua chave, cada projeto com seu modelo, nenhum com medição. Na GravitonAI a sua empresa constrói agentes sobre as próprias bases e os publica como endpoint seguro, para alimentar o atendimento ao cliente, os sistemas internos e as ferramentas de IA que o time já usa. Com dono, limite e rastro em cada chamada.
O acesso ao beta é por convite.
O problema
A adoção de IA numa empresa raramente é um projeto. É um time que testou, outro que gostou, um terceiro que contratou por fora. Quando alguém olha o conjunto, o conjunto já está assim:
Cada time contratou seu provedor. Não existe a lista de quantas chaves a empresa tem, quem as guarda, nem o que passa por elas.
O consumo de modelo não é atribuído a time, projeto ou caso de uso. A conta chega inteira, sem origem, e a única resposta possível é cortar tudo ou pagar.
Um documento interno entra num prompt e sai da empresa. Não há registro de quem perguntou o quê, sobre qual base, nem para onde o texto foi.
O acesso é controlado na tela. Dentro da execução, o agente alcança o que conseguir alcançar, e quem revisa isso descobre tarde.
E o desfecho é sempre o mesmo.
O piloto funciona. Impressiona na demonstração. E morre na revisão de segurança, ou na primeira fatura. Não porque a IA falhou, mas porque ninguém consegue responder quem acessou o quê, quanto custou e com base em qual informação a resposta foi dada. O problema nunca foi o modelo. Foi tudo em volta dele.
A promessa
A GravitonAI não é mais um lugar para colocar IA. É o lugar onde ela passa a ter as respostas que a sua empresa vai precisar dar.
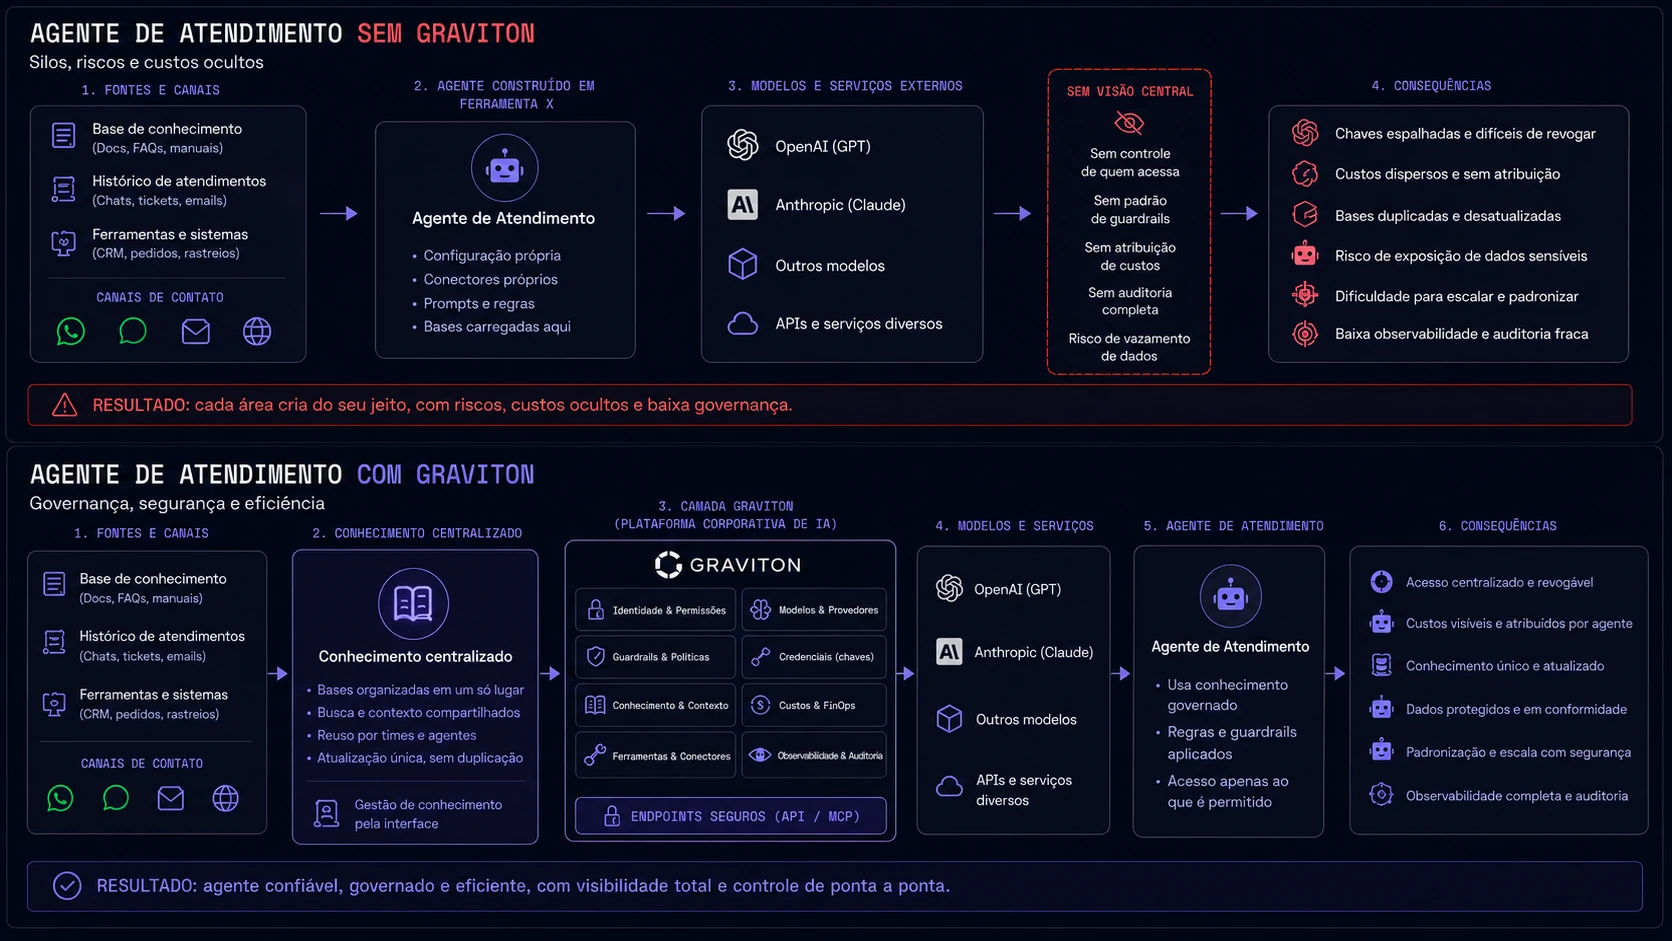
A permissão vem da identidade corporativa e é organizada por grupo. Ela vale na tela, vale na chamada de API e vale dentro da execução do agente, sem depender de a interface lembrar de verificar.
Cadastre o provedor da empresa com a chave da empresa, ou use a da plataforma. A escolha vale por endpoint, não numa configuração global que serve a todos e a ninguém.
Cada chamada de modelo é contabilizada na conta certa, com o modelo, o agente e a origem que a disparou. A pergunta "quanto a IA custou este mês" passa a ter resposta por área.
A política roda na fronteira do modelo, não numa validação de interface que qualquer chamada direta contorna.
O desfecho
É aqui que a maioria das plataformas de IA para: entregam uma interface bonita onde o agente existe e ninguém usa. O ponto aqui é o contrário. O que você monta na plataforma nasce para ser chamado de fora, pelo software que a empresa já tem e pelas ferramentas de IA que o time já abriu hoje de manhã. São duas portas independentes.
Publicou, ganhou endereço. O widget de atendimento, o portal do cliente, o sistema interno: cada um chama o agente da organização direto, com a resposta já sujeita às regras que você configurou. Ninguém precisa migrar para mais uma interface.
Um endpoint MCP à parte, que você configura e expõe, servindo as bases de conhecimento já vetorizadas para busca. Clientes como Claude Code e Codex consultam o conhecimento da empresa de dentro do próprio ambiente, sem ninguém copiar documento para fora.
Cada aplicação e cada cliente recebe a própria credencial, com escopo do que pode alcançar, validade e revogação independentes. Cortar o acesso de um integrador é revogar uma credencial, não girar um segredo compartilhado e rezar.
Chamada de aplicação, busca a partir de um cliente de IA ou execução agendada: todas atravessam o mesmo controle de acesso, os mesmos guardrails e a mesma auditoria. Não existe porta dos fundos por onde o controle não passa.
Engenharia de contexto
A maioria das implementações de IA enche o prompt com tudo o que encontrou, na esperança de que a resposta esteja no meio. A plataforma trata isso como problema de engenharia e resolve por você. O que muda na prática:
Engenharia de contexto é sobre decidir o que NÃO enviar ao modelo. Cada token que entra carrega custo financeiro, latência e distração da atenção do LLM. A arquitetura boa é a que envia o mínimo necessário para a resposta correta, não o máximo possível.
Você paga por token, e o prompt final é uma fração do que poderia ter entrado. A economia não vem de trocar por um modelo pior, vem de parar de mandar o que não era necessário.
Menos contexto é menos tempo de leitura antes da primeira palavra da resposta. Em atendimento ao cliente, isso é a diferença entre parecer instantâneo e parecer travado.
Contexto diluído distrai o modelo. Poucos trechos certos produzem resposta melhor do que uma base inteira despejada, e é por isso que enxugar não é economia à custa de qualidade.
E antes que você pergunte
Governança em plataforma corporativa costuma chegar em forma de comitê, formulário e três semanas de espera, sobre uma infraestrutura que alguém do seu time vai ter que manter de pé. Aqui as duas ficam com a gente. O seu time cuida do caso de uso.
Não há banco vetorial para dimensionar, fila para monitorar, worker para escalar, nem política de retentativa para escrever. A execução dos agentes é problema nosso.
Drive, repositórios de documento e os sistemas de trabalho que o time já usa, ligados com a credencial da organização. Você não precisa de um projeto de integração.
Extração, divisão em chunks e índice vetorial acontecem sozinhos. Não há pipeline para você construir, nem manter.
Nós de modelo, conhecimento, ferramenta e decisão, ligados no canvas. Você testa ali mesmo, e acompanha vendo cada passo acendendo enquanto roda.
E o que você publicou já nasce com as regras da organização aplicadas, sem uma segunda etapa em que alguém precisa lembrar de configurá-las.
A plataforma
A superfície é grande, mas ela se organiza sozinha quando você olha pelo que cada parte serve.
Do fluxo em branco ao agente publicado, no canvas.
Os dados da empresa viram contexto enxuto, com origem declarada.
Os sistemas que a empresa já usa, ao alcance do agente.
Duas portas para fora, cada uma com a sua credencial.
Quem pode o quê, com qual modelo, a que custo, e o registro de tudo.
A camada de acesso
É a camada que decide tudo o mais. A permissão nasce da identidade corporativa, é organizada por grupo e atravessa a execução inteira, não só a tela. Quando alguém sai da empresa, o acesso cessa no mesmo movimento e nada do que essa pessoa construiu para de funcionar, porque pertence à organização.
Quem está por trás
Antes da GravitonAI, este time colocou soluções de IA em produção em ambientes corporativos, setor após setor. Os mesmos problemas apareceram em todas: identidade que parava na tela, conhecimento espalhado, custo sem dono, execução sem rastro. Colocar IA para funcionar era sempre a parte fácil; fazer funcionar sob as regras da empresa, com uma conta que fecha, era o trabalho que se repetia. A plataforma é essa infraestrutura, extraída do que a operação cobrou.
Estamos abrindo acesso aos poucos, conversando com cada organização antes de liberar, para entender o que você quer resolver e dizer com honestidade se a plataforma resolve.